Configurar un entorno de publicación, investigación y prototipado reproducible para el desarrollo de esta tesis.
Configurar un entorno de publicación, investigación y prototipado reproducible para tesis relacionadas con el LabCI Digital.
Configurar un entorno de publicación, investigación y prototipado reproducible para el desarrollo de esta tesis.
Configurar un entorno de publicación, investigación y prototipado reproducible para tesis relacionadas con el LabCI Digital.
Investigación Reproducible
Agregar citas, agregar la documentación como código y combinar las dos, argumentando ¿por qué al usar documentación como código, obtenemos ventajas de la investigación reproducible, para procesos de publicación académica, así no estén asociados a estudios cuantitavos.
Extracción de datos en rede sociales
Mover a los anexos
una estrategia técnica y jurídicamente viable para la extracción de información correspondiente a los contenidos publicados por DatalabCI en la red social Instagram.
Quitarlo y reemplazarlo por el tema de investigación reproducible.
Video de Clar Shirky
Moverlo al marco teórico de manera más breve enfatizando la idea de que el control de versiones ha creado nuevas maneras de argumentar, que no están ampliamente expandidas. Usar citas bibliográficas para hablar de este video.
El auge de las redes sociales y el hecho de que se usen para comunicarse a un amplio público, particularmente en labores de difusión, ha implicado que mucha de la memoria institucional y comunitaria se queda alojada en dichas redes, sujeta a las políticas de acceso de ellas y a algoritmos opacos que controlan a quiénes y durante cuánto tiempo se presente la información allí publicada
Cambiar la justificación hablando de la investigación reproducible, de cómo es una práctica emergente que no está ampliamente expandida en los trabajo de investigación de pregrado y postgrado. Mencionar el trabajo de tesis doctoral de Offray Luna-Cárdenas (2019), que fue uno de los primeros prototipos de investigaciones reproducibles el país y mecionar también la tesis de Sergio del pregrado en CIBAR y Humanidades Digitales en America Latina del doctorado en Comunicación, Lenguajes e Información.
Decir por qué es importante la investigación reproducible y qué se gana con ella frente a otros procesos.
Hablar del proyecto LabCI Digital y sus características y por qué estamos incorporando investigación reproducible para el mismo, entre otras razones:
{#chap:justificacion}
Quitar esto del título
La ironía de este estado es que, la versión alpha, es decir, la versión estable, se pospone indefinidamente y por lo tanto es necesario acostumbrarse a vivir con los fallos. Nos vemos constantemente forzados a adaptarnos a la herramienta y no al contrario, y la existencia de la infraestructura se hace visible en los agujeros que dejan sus limitaciones constantes.
La versión beta es posterior a la alfa, que es más inmadura. Acá lo propio sería hablar de release candidate como siguiente versión hasta llegar a software en producción. Véase Software release life cycle.
Acá también con Grafoscopio y sus elecciones no habituales estamos en beta permanente, pero el software al ser un sistema maleable y una metaherramienta, introduce nuevas caracterísitcas para adaptarse a sus usuarios y contextos en lugar de al contrario.
No estamos preparados para la inteligencia artificial
El mapa refleja varias de las tensiones del video y los impactos negativos de la IA para la sociedad.
Es importante que el mapa mental refleje de manera más detallada la "tabla de contenido" del video, de forma que conceptos como "bosque oscuro" queden claramente articulados.
Es importante que el mapa refleje los elementos estructurales del video (su tabla de contenido) de manera más detallada.
Creo que hay varios elementos del lenguaje en los cuales el mapa no profundiza, en particular cómo las redes neuronales funciona y cómo se construyen los modelos vectoriales del lenguaje.
Nuestro objetivo es gestionar y organizar el volumen masivo de datos textuales creados en X/Twitter durante la candidatura a la alcaldía de Bogotá en X/Twitter utilizando técnicas de minería de textos. Con el uso de esta metodología innovadora, podemos examinar las ramificaciones políticas de la difusión o proliferación de información en la plataforma y producir modelos útiles que pueden aplicarse para mejorar la toma de decisiones políticas y estratégicas.
Este ya no es nuestro objetivo. Sino el de analizar la calidad de los microdatos extraídos.
Zttlr:
Zettlr
# Desplegando un entorno de investigación reproducible
Esto de acá debería ser una sección
Gráfico representativo de los datos
Mejorar explicación. Ver comentario en gráfica anterior
Gráfico representativo de los datos
Explicar mejor qué se está representando: Cantidad de datos agrupados contra tipo de dato (no es "Nombre del ítem").
Evaluaremos varias características de los datos obtenidos, como la dimensionalidad de los tweets, la densidad de los datos y la frecuencia de los hashtags, para obtener información valiosa sobre la calidad de los microdatos.
Sólo evaluamos dimensionalidad (cuántos datos hay) y densidad (que tan profundos son los datos, es decir cuántos datos agrupan). Nunca evaluamos la frecuencia de los trinos. Vale la pena definir acá qué es cada uno: dimensionalidad y densidad, y luego sí pasar a la narrativa como tal.
velocidad, capacidad de recopilar datos en tiempo real y capacidad de superar cualquier limitación potencial de la plataforma de redes sociales.
Nunca evaluamos la velocidad y de hecho la tabla comparativa no habla al respecto de nada de eso. Tampoco evaluamos la posibilidad de superar "cualquier limitación" en generar evitar el uso de absolutismos (nunca, siempre, cualquier, etc).
Squawker durante el estudio para el trabajo de guardo. La falta de una función “Batch Save” para explorar perfiles. Se tomó la decisión de abrir una línea de comunicación con los desarrolladores vía GitHub por medio de los comentarios de dicho aplicativo.
Retomar desde acá la narrativa sobre el análisis que se hizo con Squawker.
Para crear un entorno de investigación reproducible en una computadora, con sistemas operativos Windows GNU/Linux o MacOS, se instalan en ella los recursos necesarios para construir dicho entorno.
Cambiar por:
Si bien hemos mostrado, en las secciones previas las herramientas individuales y sus usos en esta investigación. Este apartado se encarga de mostrar los flujos de trabajo que conectaron las herramientas.
Hypothesis
Agregar captura de pantalla y explicación sobre para qué fue usada en el contexto de la tesis. En particular, mostrar cómo se uso para gestionar comentarios de mejoras sobre la tesis.
Pandoc
Agregar captura de pantalla y explicación sobre para qué fue usada en el contexto de la tesis. Por ejemplo, indicando que se usó para convertir de formato Markdown a HTML y PDF, aplicando diferentes plantillas para cada formato.
Zettlr
Agregar captura de pantalla y explicación sobre para qué fue usada en el contexto de la tesis.
WindTerm
Agregar captura de pantalla y explicación sobre para qué fue usada en el contexto de la tesis.
Grafoscopio es una herramienta interactiva flexible de visualización de datos y documentación.
Agregar captura de pantalla de Grafoscopio:

ExoRepo es una utilidad que facilita la instalación de repositorios hospedados en infraestructuras de código autónomas.
Esta frase debería ir arriba, antes del código de la instalación. También se debería indicar dónde se está ejecutando el código de la instalación.
Pharo ofrece un entorno interactivo y un sistema de desarrollo integrado, lo que facilita el diseño de aplicaciones complejas. GT y Pharo trabajan juntos para brindar una experiencia de desarrollo única y altamente personalizada.
Agregar gráfica y explicación breve de cómo se usó en el contexto de la tesis, siguiendo el ejemplo de Fossil.

ChiselApp es una plataforma de alojamiento y lanzamiento de proyectos que ejecuta Fossil SCM como sistema de control de versiones. Permite a los usuarios realizar un seguimiento de los cambios en los archivos, comunicar el progreso y la evolución del trabajo académico y guardar los datos recopilados mediante herramientas de scraping. ChiselApp te permite crear repositorios públicos y privados, lo que facilita el mantenimiento y la colaboración en proyectos académicos.
Como había dicho ya en las sesiones presenciales, es importante agregar una pantalla de cada aplicación en el contexto en el que fue usada. Por ejemplo, para el caso de Fossil, la imagen podría ser

Fossil fue utilizado para alojar los distintos archivos que configuran el escrito de la tesis, incluyendo tanto la prosa como las narrativas de datos, en un repositorio público y otro privado se creó para los datos extraídos con los distintos métodos. Así mismo, se empleó para publicar las versiones en borrador en distintos formatos (HTML y PDF) y para hacer comentarios para control de avances, mejoras y correcciones.
La gráfica de arriba muestra el uso de Fossil y las ramas del Tutor y el tronco que permitían trabajar de manera colaborativa en los procesos de acompañamiento de la tesis.
Publicando reproducible: Como exportamos el documento desde Markdown a HTML y PDF y cómo se hacen con Fossil.
Después del listado breve, indicar que se mostrará en detalle cada una de las herramientas y cómo fueron instaladas/utilizadas durante la tesis.
siguientes elementos
Agregar una frase corta al frente de cada uno indicando qué hacen. Por ejemplo:
y así suscesivamente. De esta manera el lector no se queda con un listado de nombres que no sabe qué significan.
Utilizando técnicas de minería de datos para descubrir patrones y tendencias de comportamiento, generando y organizando el volumen masivo de datos textuales creados en Twitter/X durante las candidaturas a la alcaldía de Bogotá en cooperación con las partes interesadas.
Esta parte no se distingue mucho de la anterior. En realidad, acá no hicimos diseño participativo, sino que pasamos directamente a la fase de diseño de producto, pues no sometimos nuestros prototipos a ninguna pluralidad de personas, por ejemplo a una comunidad.
Imagen representativa de la metodológia
Se debe indicar que esta imagen fue tomada de mi tesis o de mi microwiki.
Este proyecto se guía por una metodología de diseño basada en investigación que se caracteriza por la creación de prototipos continuos. Este enfoque, en línea con el pensamiento de diseño y las epistemologías diseñistas, reconoce el diseño como un conocimiento en red, capaz de incorporar métodos cuantitativos, cualitativos, etnográficos e investigación acción participativa.
Es importantísimo decir que esta parte del texto es tomada casi literalmente de mi wiki, citando la fuente e indicando que dicho contenido fue cedido al dominio público por mí.
La mineria de datos es importante para sacar conclusiones interesantes a partir de conjuntos de datos masivos, que se aplica con gran éxito al analizar redes sociales como Twitter/X. Durante este proceso se recopilan y procesan cantidades masivas de datos generados por los usuarios, como tweets, encontrando patrones y tendencias (Blázquez., 2019) . La minería de datos se utiliza para detección de tendencias en tiempo real y el análisis de los tweets (Blázquez., 2019). Con el uso de esta técnica, las personas pueden clasificarse en varias categorías según sus intereses y comportamientos. También se pueden identificar eventos cruciales o emergencias.
Si bien usamos minería de datos para extraer los datos, lo clave no fue su tamaño, sino su calidad. Este párrafo debería expresarlo. También es necesario plantear elementos de ciencia abierta y reproducible en los tipos de estudios que estamos realizando, pues es una parte importante del problema y de los objetivos específicos y no hay nada al respecto en la justificación.
Este estudio se centra en examinar cómo las redes sociales han afectado las campañas políticas, particularmente las de las elecciones regionales del año 2023 en Bogotá. La información política que Gustavo Bolívar y Juan Daniel Oviedo publicaron en Twitter (ahora denominada ”X” y que a lo largo de esta tesis se denominará Twitter/X) a lo largo de su campaña será analizada mediante minería de textos.
Si bien hicimos minería de texto, no fue para examinar cómo las redes sociales afectaban campañas, sino que nos enfocamos en la calidad de los datos extraídos de Twitter.
mejor cómo se distribuye y consume la información en la plataforma
Esto no se analizó.
la investigación examina cómo la información política sobre X/Twitter afecta la participación de los ciudadanos, la transparencia y la capacidad de tomar decisiones bien informadas
Esto no fue lo que se examinó. Corregir de acuerdo a lo que sí se hizo.
de cuánta información
Nunca analizamos cuánta información se podía extraer, sino cual era su calidad.
Al analizar el impacto político en X/Twitter utilizando la minería de textos como herramienta, el proyecto ofrece un enfoque novedoso al tema en cuestión. Esto nos permite comprender de una manera más precisa y profunda cómo la difusión de información impacta los procedimientos electorales y la opinión pública a lo largo de la campaña a la alcaldía de Bogotá.
Esto no fue lo que se analizó. Nunca revisamos ni impacto, ni difusión de información.
X/Twitter
X/Twitter
X/Twitter
X/Twitter
X/Twitter
X/Twitter
Twitter/X
técnicas
~~tecnicas~~ ~> fuentes
Twitter/X
X/Twitter
X/Twitter
Usar siempre Twitter/X y no una veces así y otras al contrario.
documentLinks do: [:link | thisSnippet database importDocumentFrom: link ].
smalltalk
myPages := documentLinks collect: [:link |
     thisSnippet database importDocumentFrom: link
].
En lugar de do: es un collect: para que la nueva colección quede asignada a la variable myPages. Una vez esto funcione, el resto de las intrucciones permite exportar sólo las nuevas páginas, en lugar de todas.
documentLinks
~~documentLinks~~ ~> myPages
Con este nuevo iterador, es posible trabajar con la colección deseada:
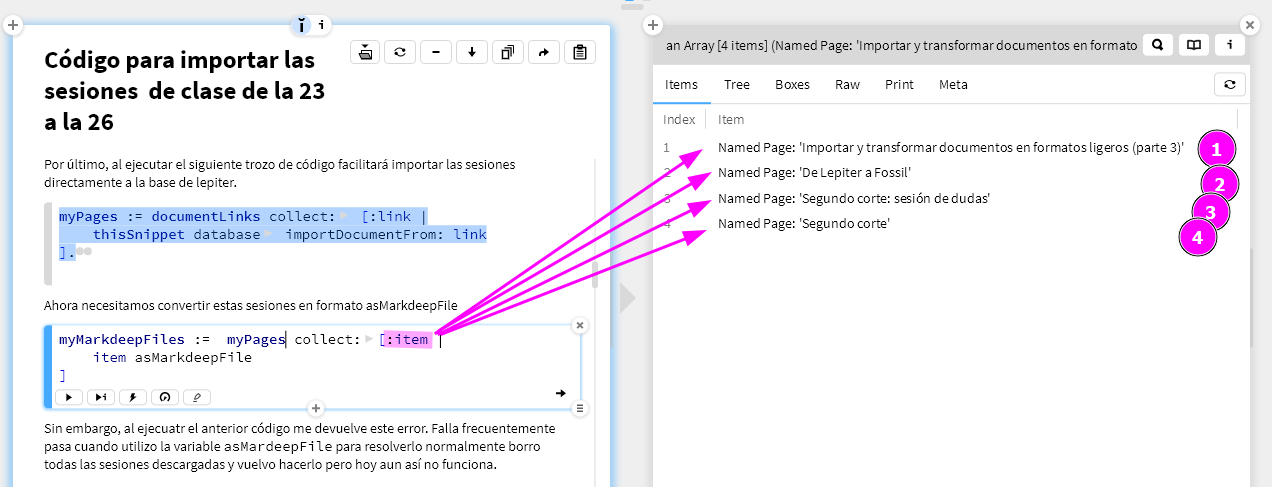
Una vez se trabaja con la colección correcta, el resto del código funciona y las páginas se pueden exportar.
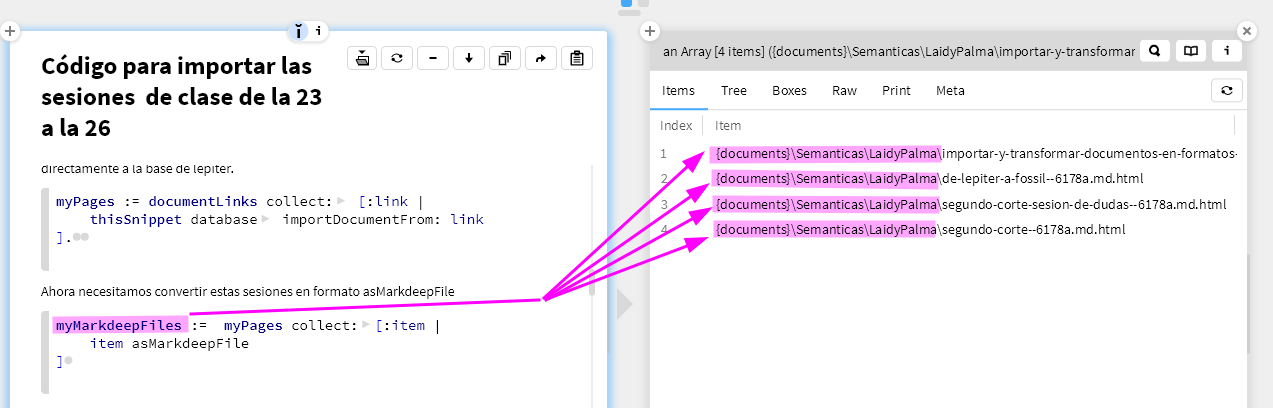
documentLinks collect: [:link | thisSnippet database importDocumentFrom: link ].
Este resultado hay que reusarlo, asignándolo a una variable.
smalltalk
myPages := documentLinks collect: [:link |
    thisSnippet database importDocumentFrom: link
].
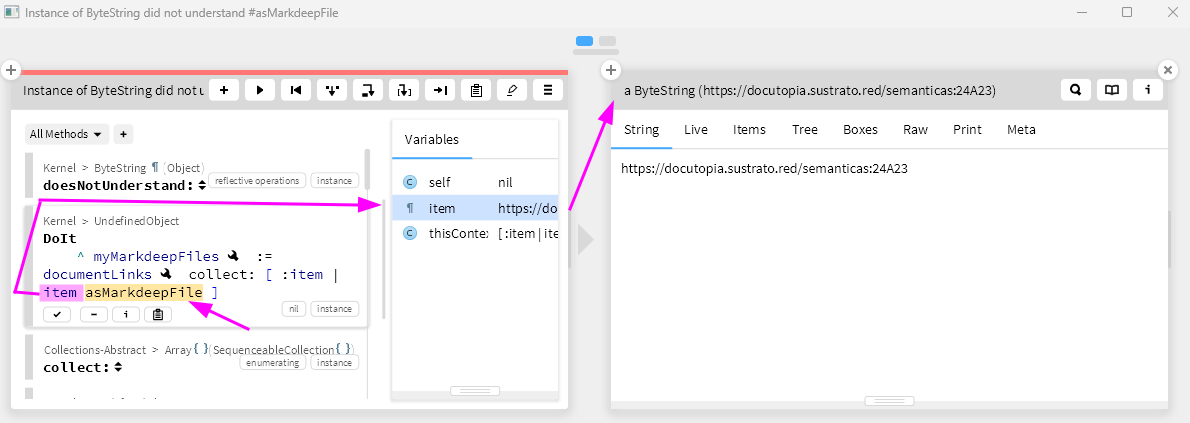
Falla frecuentemente pasa cuando utilizo la variable asMardeepFile para resolverlo normalmente borro todas las sesiones descargadas y vuelvo hacerlo pero hoy aun así no funciona.
Enviaste el mensaje asMarkdeepFile a un String (cadena de texto en lugar de a una página de Lepiter. Tendrías que haber enviando el mensaje a una Named Page.
Debes completar la narrativa de datos para que, efectivamente descargue las memorias del seminario taller, intercalando prosa, código y gráficas.
Debes intercalar prosa con código en una narrativa de datos.
No has agregado al repositorio, las memorias que descargaste.
Data Weeks: Guardar las memorias del evento
El título ya no corresponde a los Data Weeks, sino al seminario taller de unidades semánticas.
Agregar los archivos descargados al repositorio.
'16-'
este nombre no corresponde a los índices descriptivos de lo que estamos haciendo. Sería mejor algún índice como sesion-.
Dado que ya tienes archivos denominados 16-*.md tienes que borrarlos del repositorio con el comando:
fossil rm wiki/es/DataWeek/*.md
fossil rm wiki/es/DataWeek/*.md.html
Falta completar la narrativa con el comando del commit y unas que le anteceden a trozos de código
repositoryFolder := FileLocator documents / 'Mutabit/Repo/'.
Este folder debería corresponder a la ubicación personal del repositorio
ugerente
sugerente
comoversionado semántico
Acá sería bueno reemplazar en enlace por la página en español:
a logrado s
ha logrado
s pretenciones
pretensiones
adjacentes
adyacente adjetivo Que está muy próximo o unido a otra cosa.
e
el
uns
una